- 聚类分析
- KMeans
- 竞品分析
- Python
- 特征工程
- 数据可视化
汽车产品聚类竞品分析
基于天池教学赛的 205 款车型数据,用 KMeans(K=12) 完成产品聚类与大众竞品识别,输出市场分层画像与竞争策略。
背景
以竞品分析为背景,对汽车产品做聚类分群、构建产品画像,并为大众(Volkswagen)找出竞品车型,为产品定位提供数据决策。数据来自天池【教学赛】数据分析达人赛3《汽车产品聚类分析》(car_price.csv,205 款车 × 26 字段,源自 UCI Automobile 数据集,1985 年车型)。
目标
- 不靠”拍脑袋”,用无监督聚类还原汽车市场的真实产品分层。
- 在特征空间里为大众精确找出竞争强度最高的车型,而非简单”同价位即竞品”。
- 产出可直接写进简历与面试的量化结论。
方案
六步分析流程:
- 数据体检:205 行 × 26 列,无缺失无重复;但
CarName存在 6 处品牌拼写错误(赛题埋坑)。 - 品牌清洗:修正
maxda→mazda、vokswagen/vw→volkswagen、porcshce→porsche、toyouta→toyota等,清洗后 22 个品牌、大众 12 款正确归并。 - 特征工程:初选 14 个数值特征,按 |r|>0.85 去共线性(wheelbase/carlength/carwidth 三选一、citympg/highwaympg 留一)+ 5 个关键类别特征 one-hot →
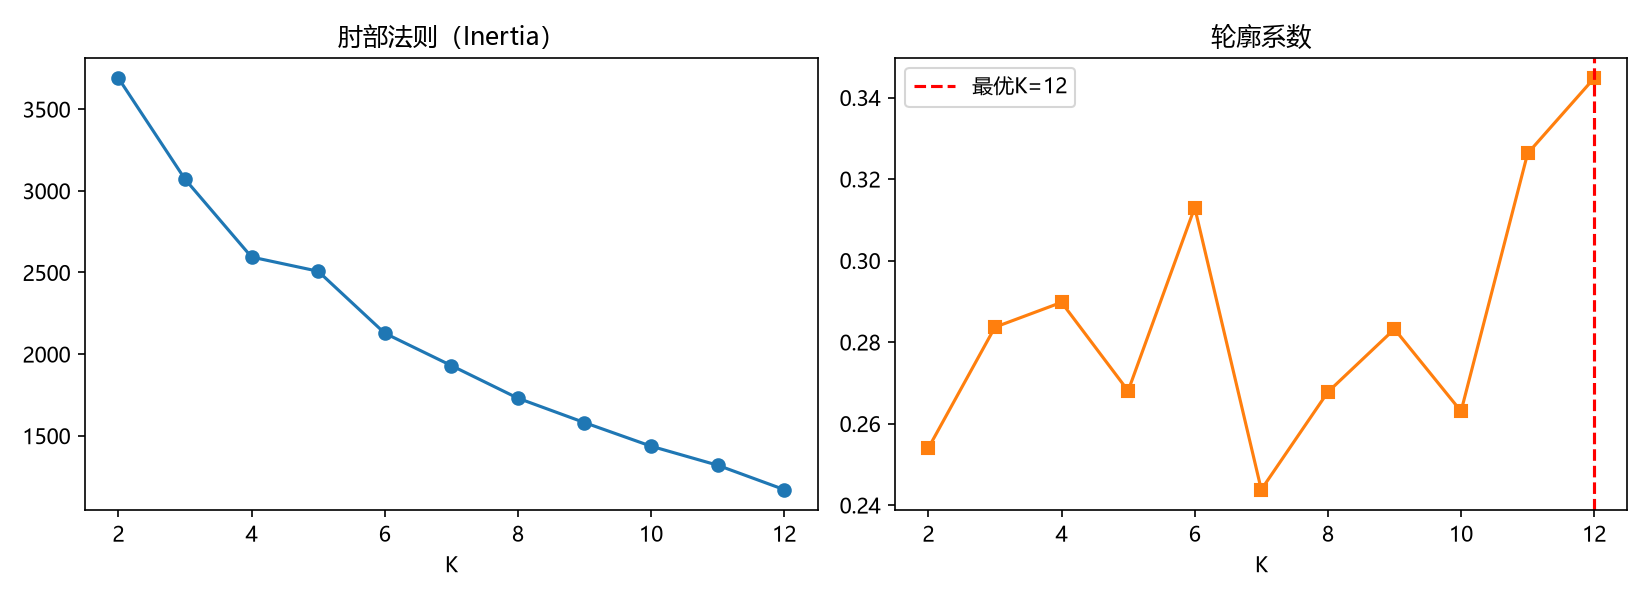
StandardScaler标准化,最终 23 维特征矩阵。 - 选 K:肘部法则 + 轮廓系数扫描 K=2~12,**K=12 时轮廓系数最优(0.345)**且商业含义清晰。
- KMeans 聚类:
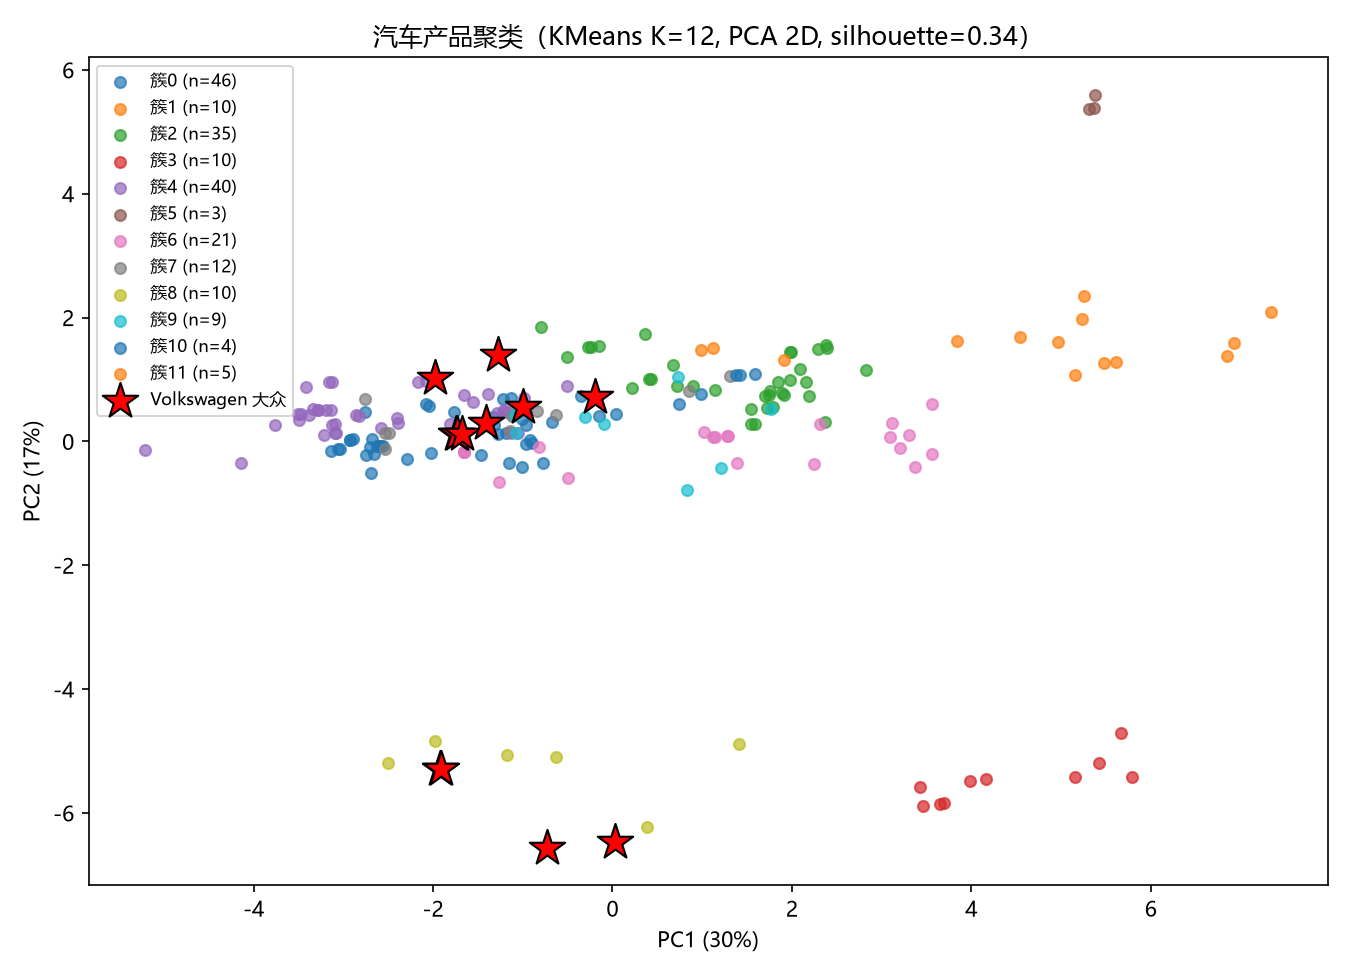
random_state=42, n_init=10,PCA 降维可视化验证分群合理。 - 竞品识别:计算 12 款大众在特征空间的簇中心,按欧氏距离排序全部非大众车型,取 Top12 为竞品——比只看”同簇”更精细。
聚类结果:K=12 的产品分层
| 簇 | 数量 | 均价($) | 马力 | 主流车身 | 代表品牌 | 定位解读 |
|---|---|---|---|---|---|---|
| 4 | 40 | 7,630 | 75 | hatchback | 丰田/本田/马自达 | 经济代步两厢 |
| 0 | 46 | 9,193 | 85 | sedan | 日产/丰田/本田 | 主流经济轿车 |
| 8 | 10 | 10,173 | 62 | sedan | 大众/丰田/马自达 | 超经济节能轿车 |
| 7 | 12 | 9,997 | 89 | wagon | 日产/斯巴鲁/奥迪 | 实用旅行车 |
| 10 | 4 | 9,384 | 104 | hardtop | 丰田/日产 | 硬顶运动经济 |
| 9 | 9 | 11,088 | 95 | wagon | 斯巴鲁/奥迪/丰田 | 四驱跨界旅行 |
| 2 | 35 | 15,538 | 122 | sedan | 丰田/沃尔沃/宝马 | 中端家用/安全 |
| 6 | 21 | 14,912 | 140 | hatchback | 三菱/沃尔沃/道奇 | 中端性能两厢 |
| 11 | 5 | 18,863 | 117 | convertible | 阿尔法/别克 | 敞篷个性车 |
| 3 | 10 | 21,503 | 107 | sedan | 标致/别克/沃尔沃 | 中高端行政 |
| 1 | 10 | 36,470 | 197 | sedan | 宝马/捷豹/别克 | 豪华性能行政 |
| 5 | 3 | 34,528 | 207 | hardtop | 保时捷 | 跑车(独成一簇) |
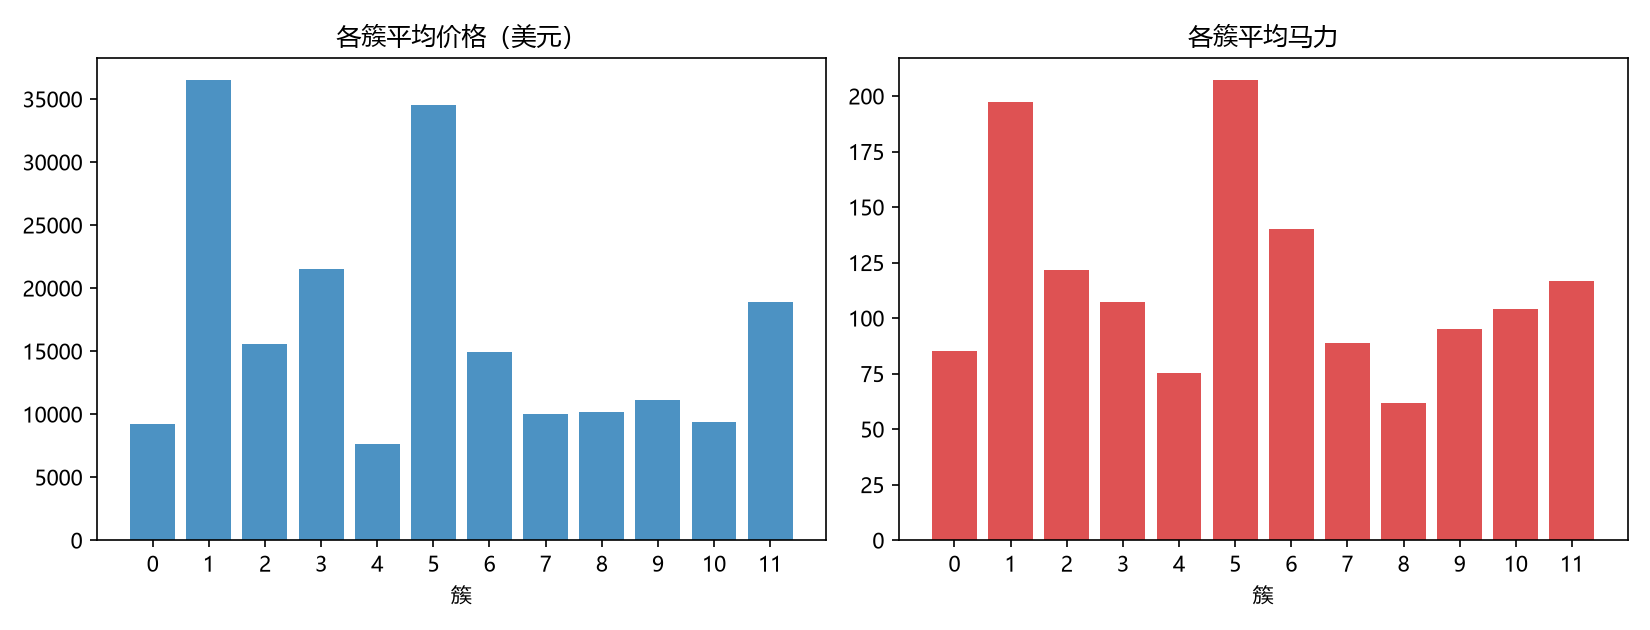
结构洞察:价格梯度($7.6k→$36.5k)与车身形式共同决定市场分层,聚类自动还原了”经济→中端→豪华→跑车”的定位阶梯;保时捷 3 款车独成一簇,是分群有效性的天然佐证。
大众的竞品识别(核心结论)
大众 12 款车集中在簇 0(主流经济轿车)和簇 8(超经济节能轿车),均价 $7.8k–13.8k、马力 52–110。按欧氏距离排序的 Top 竞品:
| 竞品车型 | 品牌 | 价格($) | 马力 | 高速油耗(mpg) |
|---|---|---|---|---|
| honda civic (auto) | 本田 | 10,345 | 100 | 31 |
| audi 100 ls | 奥迪 | 13,950 | 102 | 30 |
| nissan nv200 | 日产 | 9,549 | 97 | 34 |
| toyota mark ii | 丰田 | 9,258 | 70 | 34 |
| nissan latio | 日产 | 7,499 | 69 | 37 |
| nissan leaf | 日产 | 7,299 | 69 | 37 |
| mitsubishi pajero | 三菱 | 8,189 | 88 | 32 |
| toyota mark ii | 丰田 | 6,938 | 70 | 37 |
| mitsubishi montero | 三菱 | 6,989 | 88 | 32 |
| nissan rogue | 日产 | 6,649 | 69 | 37 |
| mazda glc deluxe | 马自达 | 7,395 | 68 | 38 |
竞品分析结论(可写进简历 / 面试的判断):
- 大众的直接竞品是日系经济型轿车:本田 Civic、丰田 Mark II、日产 Sunny 级、马自达 GLC——同价位、同三厢形态、油耗接近,正面竞争。
- 奥迪 100 LS 入选体现”簇内高端重叠”:大众 rabbit custom($13,845)价格上探后与奥迪入门款重叠,同集团跨品牌内部竞争被数据捕捉到。
- 差异化护城河在”超经济节能”(簇 8:高速 41+ mpg、马力仅 52–68 的柴油/小排量线),独立成簇,与日系拉开身位。
- 产品线跨簇是大众战略特征:从 $7.8k rabbit 到 $13.8k rabbit custom 横跨三簇(多价位多产品线),而日系竞品多为单一价位精准卡位。
简历表达(一段式)
对 205 款车型 26 维数据完成品牌拼写清洗、共线性特征筛选与 one-hot 编码,构建 23 维特征矩阵;以肘部法则+轮廓系数确定 KMeans K=12,聚出”经济→中端→豪华→跑车”四级产品分层(保时捷独成一簇验证分群有效性);在特征空间计算大众簇中心欧氏距离,识别出本田 Civic、丰田 Mark II、奥迪 100LS 等 12 款竞品车型,并产出”超经济节能差异化 + 多价位产品线”的竞争策略结论。
面试追问预判
- 为什么 K=12? 轮廓系数最优 + 每簇商业可解释(保时捷独簇佐证分群有效)。
- 为什么不用 RFM? 这是产品聚类不是用户聚类,特征选产品物理属性 + 价格,方法论同源但特征体系按业务重设计。
- 竞品为什么用距离而不是同簇? 同簇是粗筛,距离排序给出竞争强度排名,且能捕捉跨簇价格上探竞品(奥迪 100LS)。